ycliper

Популярное

Музыка Кино и Анимация Автомобили Животные Спорт Путешествия Игры Юмор

Интересные видео

2025 Сериалы Трейлеры Новости Как сделать Видеоуроки Diy своими руками

Топ запросов

смотреть а4 schoolboy runaway турецкий сериал смотреть мультфильмы эдисон

Видео с ютуба Single Stream Inference
How AI Models Scale Beyond a Single GPU Across LLM Workloads

How AI Models Scale Beyond a Single GPU Across LLM Workloads

AI Inference: The Secret to AI's Superpowers
AI Inference: The Secret to AI's Superpowers

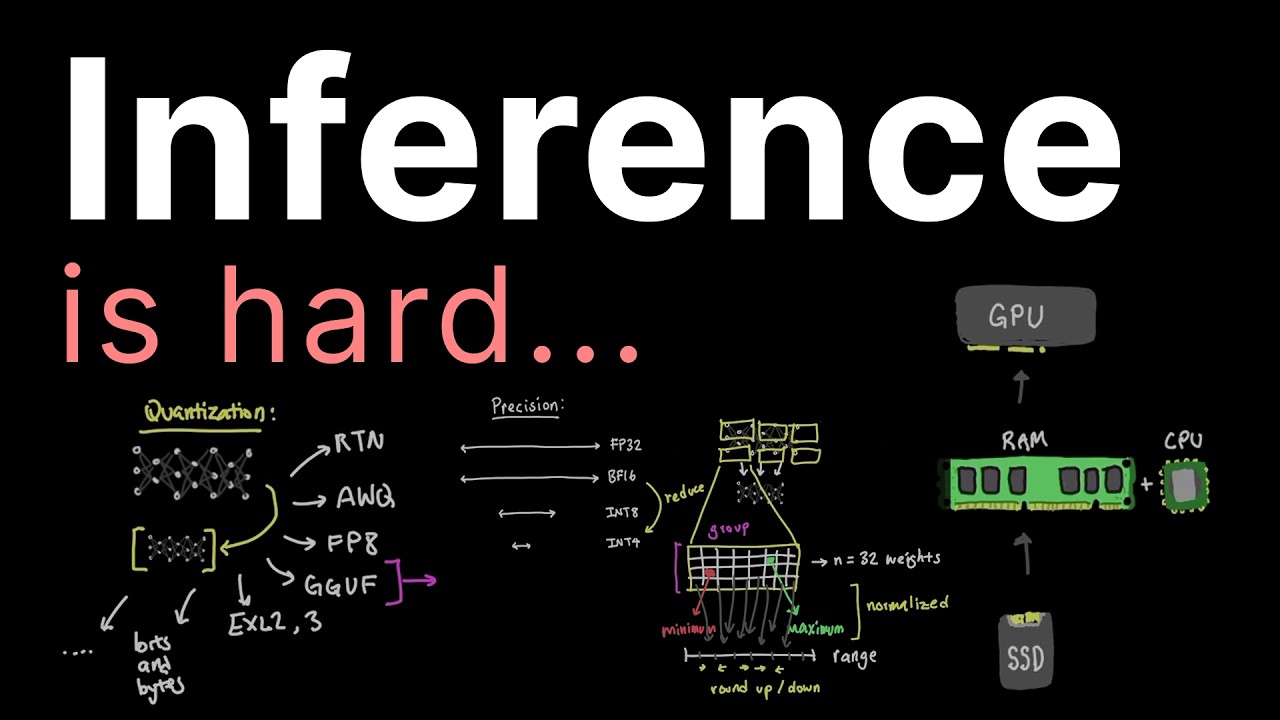
Почему делать логические выводы сложно...

Почему делать логические выводы сложно...

LLM Inference Is a Memory Problem, Not a Compute One
LLM Inference Is a Memory Problem, Not a Compute One

Inference at Scale: The New Frontier for AI Infrastructure and ROI

Inference at Scale: The New Frontier for AI Infrastructure and ROI

Механизмы инференса за 10 минут..

Механизмы инференса за 10 минут..

What Is LLM Inference? How AI Models Generate Responses

What Is LLM Inference? How AI Models Generate Responses

Как работает инференс в масштабе? Движки vLLM и SGLang

Как работает инференс в масштабе? Движки vLLM и SGLang

What Is an Inference Engine? DeepSeek Just Open-Sourced One

What Is an Inference Engine? DeepSeek Just Open-Sourced One

Deep Dive: Optimizing LLM inference

Deep Dive: Optimizing LLM inference

Понимание рабочих нагрузок при инференсе LLM — Марк Мойо, NVIDIA
Понимание рабочих нагрузок при инференсе LLM — Марк Мойо, NVIDIA

Поставщики выводов: лучший способ разработки с использованием моделей с открытым исходным кодом

Поставщики выводов: лучший способ разработки с использованием моделей с открытым исходным кодом

Странная экономика LLM-инференса как услуги

Странная экономика LLM-инференса как услуги

Учебное пособие по Amazon Bedrock: Выполнение LLM-выводов в одиночном и пакетном режимах на Amazon.

Учебное пособие по Amazon Bedrock: Выполнение LLM-выводов в одиночном и пакетном режимах на Amazon.

Механизмы вывода (Часть 1)
Механизмы вывода (Часть 1)

Why AI Inference is a Memory Bandwidth Problem
Why AI Inference is a Memory Bandwidth Problem

How to EASILY make your own Local AI Supercomputer | Distributed Inference Explained
How to EASILY make your own Local AI Supercomputer | Distributed Inference Explained

How vLLM Became the Standard for Fast AI Inference | Simon Mo, Inferact

How vLLM Became the Standard for Fast AI Inference | Simon Mo, Inferact

Inference Engineering Is the Most Important AI Skill Right Now: The 4-Layer Stack

Inference Engineering Is the Most Important AI Skill Right Now: The 4-Layer Stack

Run A Local LLM Across Multiple Computers! (vLLM Distributed Inference)

Run A Local LLM Across Multiple Computers! (vLLM Distributed Inference)

Следующая страница»

© 2025 ycliper. Все права защищены.


  • Контакты
  • О нас
  • Политика конфиденциальности


Контакты для правообладателей: [email protected]